


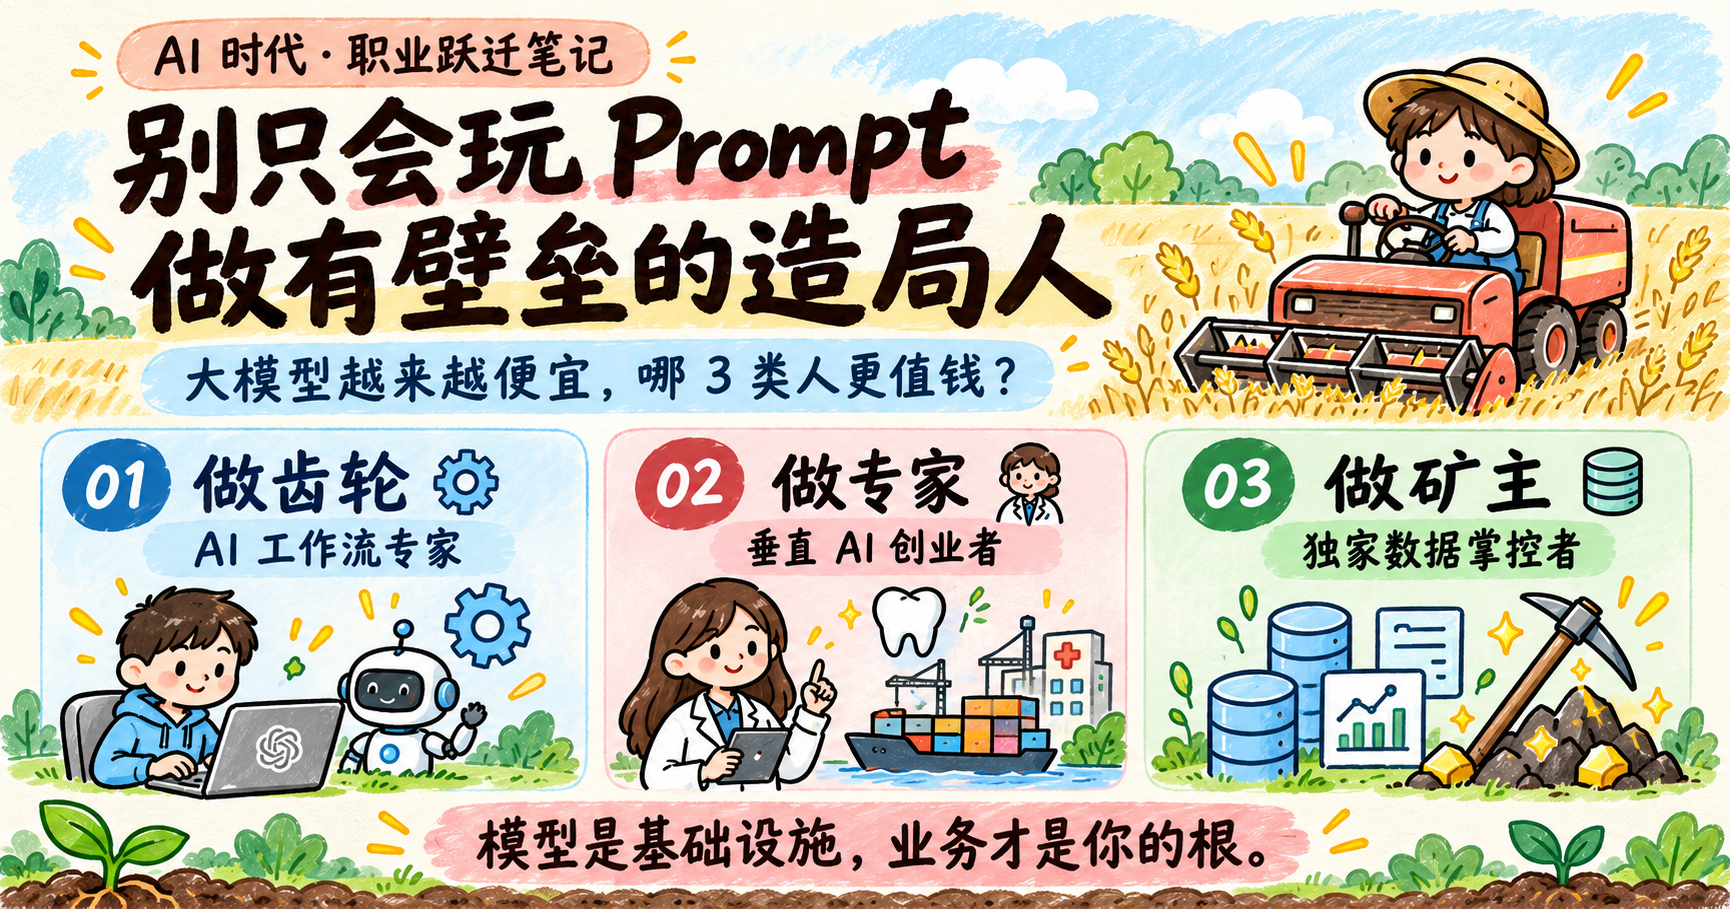
你有没有发现,AI 圈正在经历一场静悄悄的“去虚向实”?
一两年前,社交媒体上满天飞的是“精选 100 个必用提示词”、“用 ChatGPT 一分钟生成网站”;但到了今天,通用大模型的能力越来越强、调用成本断崖式下跌,那些靠浅层套壳、倒卖提示词的人却集体哑火了。
底座模型越强,通用的浅层中间层死得越快。
如果大模型本身正在变成像水和电一样的通用基础设施,那么真正能在这个时代赚到钱、建立长期职业壁垒的人,到底在做什么?
答案其实非常清晰:他们不再跟大模型“正面硬刚”,而是找到了大模型触碰不到的三个核心生态位。
AI 时代的“商业新三角”:三种真正有壁垒的生态位
            ▲ 行业深度与业务理解力 (Domain Knowledge)
                            │
    [ 垂直 AI 创业者 ]              [ 独家数据把关人 ]
    • 模式:解决行业极深痛点          • 模式:打造数据飞轮
    • 壁垒:懂潜规则与交付           • 壁垒:私有资产不可替代
    ────────────────────────┼──────────────────────────────► 资产排他性
    [ AI 工作流专家 ]               [ 浅层套壳应用 (高危区) ]
    • 模式:积木式交付、降本提效     • 风险:极易被大模型迭代吞噬
    • 壁垒:工程连接与业务拆解      • 状态:无技术深度,无私有资产
                            │
1. 做 AI 工作流的人:企业需要的是稳定可靠自动运转的流程
但在企业端,只要还需要人工来回复制粘贴、人肉盯进度,这种 AI 就没有任何严肃的生产力意义。
同样只要还存在这样高耗人工, 以及不以解放人和生产力的流程 都应该可以考虑 AI 的流程介入, AI不应该是挤掉人类工作, 而是替代 根本就不需要耗人的流程.
我小学还存在“割麦假”, 但是随着联合收割机的普及, 我已经很久没有割过麦子了, 但是依然需要我爸爸妈妈管理农田和决定收割. 我的意思: AI 是工具, 就像联合收割机, 需要找到合适的麦田, 解决最累人的流程.
工作流的搭建者, 他不关心模型懂不懂哲学,只做一件事:把 AI 像智能齿轮一样接到企业已经在用的工具里,让整条业务流程自己跑起来。
例如:
- 销售线索清洗: 官网表单收到一个新客线索 ➡️ AI 自动调用企业数据接口查询公司规模与融资情况 ➡️ 自动打分分类 ➡️ 优质线索直接推送到销售的即时通讯工具,并附带针对性的破冰话术。
- 财务与开票: 邮箱收到供应商发票 PDF ➡️ 多模态 AI 自动识别税号、金额、明细 ➡️ 自动核对合同并写入 ERP 系统 ➡️ 异常自动拦截并抄送财务负责人。
- 高吞吐实时金融事件解析系统: 市场各种信息 ➡️ 图片, 财报, 甚至小到消息的自动汇集清晰 ➡️ 供给股票操控者 ➡️ 决策买入卖出
这类人卖的从来不是“AI 技术有多玄妙”,而是确定性的 ROI(投资回报率)。一个能让团队每月省下 100 小时人肉搬运的工作流,企业愿意直接为它支付真金白银。
核心技能:熟练掌握 n8n、Flowise、Dify、LangGraph 等编排工具,深耕 Webhook、API 打通与主流 SaaS 系统的协同。你的壁垒不是写代码,而是对业务链条的极致解构能力。
2. 做垂直 AI 的创业者:通用模型越泛化,行业孤岛越值钱
选择“倒立行走”:只服务一个极窄、极深的垂直行业。
例如:
- 牙科诊所管理 AI:它不需要懂宏观经济,但它必须精通医疗影像的合规存储、懂医保报销目录的申报规则、懂牙医和病患沟通中的合规禁忌词。
- 跨境物流报关 AI:它深谙全球各个口岸的 HS Code 归类逻辑、提单审核格式与关税豁免条款。
通用大模型就像一个“满腹经纶的高考状元”,而垂直行业要的是一个“在车间、律所或码头摸爬滚打十年的老师傅”。状元虽然绝顶聪明,但不懂行业黑话、不懂合规红线,更不懂线下复杂交付中的“潜规则”。
核心策略:不要试图做所有人的神器。挑一个现金流充沛、痛点极痛、且通用模型直接用会“频繁翻车”的垂直领域,把所有精力花在合规、深度业务流集成和垂直体验上。行业越深,城墙越厚。
3. 掌握独家数据的人:算力易得,私有“数据飞轮”千金难求
随着开源模型与轻量化模型的爆发,模型训练与推理的成本正在呈指数级下降。
这带来了一个残酷的现实:凡是公开互联网上能爬到的知识,未来都会变成免费的廉价品。
那么未来的终极壁垒在哪里?在独家、动态、未公开的私有数据手里。
- 一家头部的工业检测公司,拥有数十万张特种工业零部件在极端工况下的高清缺陷标定图谱;
- 一家本地房产托管平台,掌握了过去五年特定区域商圈最真实的租金成交波动与房东底价画像。
这些数据,公网爬虫抓不到,大厂实验室合成不出来。谁手里握有这些高质量的行业专有数据,谁就能微调出行业内精度断层领先的专用模型;而随着客户的使用,这个系统还能持续沉淀更多真实反馈,形成不可逆的**“数据飞轮”**。
核心认知:如果你的业务本身就能在日常运转中“副产”独特的数据,请立刻把它们转化为结构化资产;如果你在考虑创业,先问自己一句:“我的数据是从哪儿来的?竞争对手花钱能直接买到吗?”
如何做信息搜索与反向验证?(拒绝信息焦虑)
面对纷繁复杂的 AI 概念,盲目刷资讯只会加重内耗。你需要带着明确的“反向验证问题”去构建自己的情报网络:
| 生态位 | 核心搜索渠道 | 关键词搜索矩阵 | 核心验证指标(去伪存真) |
|---|---|---|---|
| 1. AI 工作流架构师 | • GitHub Trending(聚焦自动化工具生态) • Zapier / Make / n8n 模版市场与社区 • 海外 X/Twitter 落地型独立开发者 |
n8n enterprise usecaseLLM agent automation ROIDify 企业自动化交付案例 |
真实工时节省:客户是在尝鲜,还是真的因为省下人手而持续续费? |
| 2. 垂直行业 AI 创业者 | • 垂直行业智库(律新社、丁香园、运联智库等) • ProductHunt(垂直标签:LegalTech, HealthTech) • Y Combinator 垂直类入选项目的对标分析 |
[具体行业] + 痛点/合规 + LLM垂直行业 SaaS churn rateAI 报关 / AI 诊所 合规门槛 |
模型脱敏度:通用基座模型若能力暴涨,核心功能是否依然不可替代? |
| 3. 独家数据掌控者 | • Hugging Face 行业特定数据集趋势 • 垂直行业上市公司的年报与招股书(看数据资产) • 行业协会内部年鉴与专有数据流平台 |
Domain-specific dataset moat私有知识库 飞轮效应行业标注数据 获取边际成本 |
采集排他性:数据是静态公开库,还是由业务闭环每天自主产生? |
结语:在狂潮中锚定你的不可替代性
AI 浪潮正在大浪淘沙。第一阶段“玩概念、做玩具”的红利期已经正式落幕,第二阶段“算 ROI、拼壁垒”的硬仗才刚刚开局。
别再沉迷于每天搜罗几十个新出的通用提示词了。合上电脑,审视一下自己手头的业务与资源,问自己三个问题:
- 我能不能做“齿轮”? 把 AI 拼装进现有的复杂业务流程中,真真切切地帮团队省下时间;
- 我能不能做“专家”? 钻进通用模型看不清的行业毛细血管,去解决那些最繁琐、最依赖线下经验的痛点;
- 我能不能做“矿主”? 筑起数据的深沟高垒,建立别人无论换多少套提示词都复制不了的私有资产。
大模型负责改变世界;而真正把价值收进囊中的,永远是那些脚踩泥土、深扎业务的造局人。
正在加载讨论…
在 GitHub 查看